🚀 SuperSIHub 3.0 全新上线!精选 SI/AI 工具,支持大模型 Token 订阅与提示词教程
申请收录工具 →


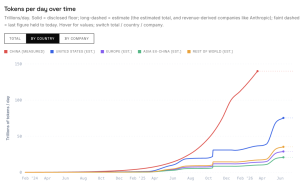
国外某统计网站估算,全球接近一半的 Token,都跑在中国模型上。
以海外最主流的模型调用平台 OpenRouter 的周度数据为例:2026 年 10 月 5 日到 11 日这一周,全球消耗 172 万亿 token,其中中国模型占 86.74 万亿,超过 50%。
而根据中文在线 6 月发布的《投资者关系活动记录表》,国内 Token 消耗中,“AI 短剧与视频生成”占 55%,电商与营销占 24%,软件开发占 15%。
短剧有多火,大家应该已经很有体感。截至 2026 年 10 月,红果短剧日活达到 2.2 亿,超过腾讯视频、爱奇艺、优酷和芒果 TV 的日活总和,用户平均每天在里面待 125 分钟。
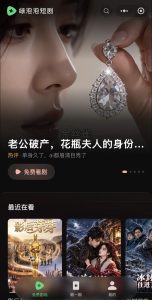
最近,微信也开始亲自下场,推出“绿泡泡短剧”免费小程序。
其首发的 AI 短剧《影后芽芽》,上线 3 天,播放量便达到数亿次。微信披露,绿泡泡剧目的人均观看时长是大盘的 5 倍,留存率超过 2.5 倍。
从“红果果”到“绿泡泡”,短剧平台争夺的不只是观众,还有源源不断的内容供给。
文字模型写一段台词,处理的是几百上千个文字 Token。视频模型要处理的,却是连续的画面、动作、光影、声音和人物一致性。
字节 BytePlus 公布的 Seedance 计费说明显示,视频 Token订阅的消耗会随着时长、分辨率、帧率和画面尺寸增加。
中文在线在材料中也提到,1080p AI 仿真人剧的 Token 消耗,通常是 720p AI 漫剧的 2~3 倍。
真正为这些 Token 付账的,是平台的补贴预算。
短剧已经拥有一条成熟的流水线:上游有网文 IP,中间有制作和投流团队,下游有广告、付费、电商和出海。AI 不必重新发明一个行业,只要接进去,就能立刻开工。
平台也需要大量内容填满推荐流,于是纷纷拿出保底、分账、流量和制作补贴吸引创作者。
红果走的是免费路线,不付费、不买会员,看十几秒广告解锁下一集,也就是所谓 IAA 模式。平台收入来自广告库存,而广告库存直接和用户时长挂钩。
在这个模型里,“买内容”就是“买流量”,因此算力成本也是获客成本。 于是补贴规模就变得很可观:抖音集团短剧版权中心 2026 年真人短剧的保底扶持预算超过 15 亿元,部均保底金额比上年提高约 60%。
微信的“绿泡泡短剧”也是类似的逻辑。制作方把剧接入官方小程序,观众免费看,收入主要来自广告。微信 2026 年第四季度的激励政策规定,人均观看时长达到 10 分钟的优质新剧,最高可以获得 100% 收入激励。
于是,一套循环转了起来:平台补贴内容,内容方购买流量,用户观看广告,广告收入再拿来生产更多内容。
短剧烧掉的 Token,也就成了这场流量循环的燃料。
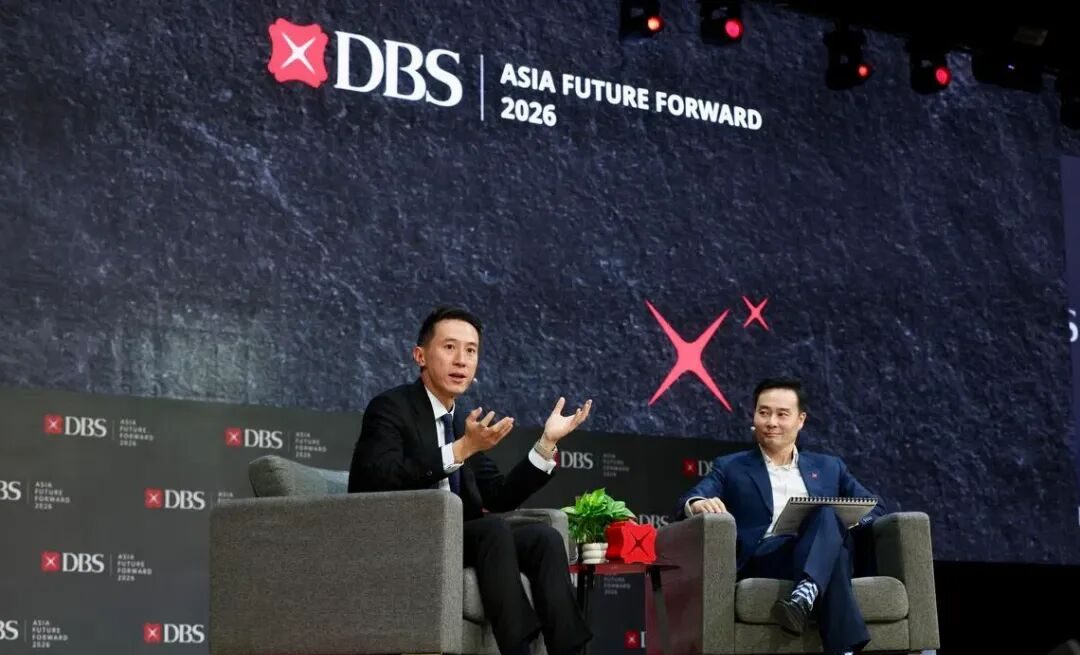
TikTok CEO 周受资 10 月中旬透露,过去制作一条视频广告需要 100~1000 美元,现在借助 AI,成本可能降到 1~10 美元。成本下降,供给自然爆炸。
广电总局也披露,2026 年前 8 个月,全国上线微短剧 43 万部,是上一年全年的 13 倍,其中 AI 剧占比超过九成。平均下来,每天有近 1800 部新剧上线。
不过,平台的补贴也在从“普遍撒钱”转向“只押精品”。
2026 年以来,多家制作方称红果收紧了部分中小项目的保底,更多项目改为按效果分成。红果随后否认“全面取消保底”,强调部分优质剧本依然能够获得支持。
当补贴开始向少数精品集中,大量依靠保底生存的制作团队,只能自己承担短剧无人观看的风险。
周受资在同一场合其实也泼了盆冷水。他提醒说,AI 生成的内容创作者数量,远远超过了 AI 内容的观看量。AI 内容目前只占观看量的个位数百分比,人们依然更看重真实、原创的东西。
一部最终无人观看的短剧,同样可能经历剧本生成、分镜、配音和几十次抽卡,最终消耗大量 Token。
所以,Token 高消耗可能意味着需求旺盛,也可能只是供给端的试错和投机同样旺盛。
相比之下,有数据显示,美国超过一半的 token 用于编程和技术研发。
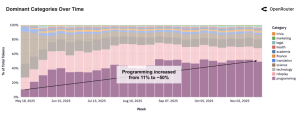
OpenRouter 与 a16z 分析了平台上超过 100 万亿 Token。结果显示,2025 年初,编程类请求只占 11%;到了年底,已经超过 50%,成为增长最快的使用场景。
OpenAI 的企业数据也呈现出类似趋势:截至 2026 年 6 月,在企业客户产生的 Codex 和 ChatGPT 输出 Token 中,Codex 已经占到 64%。
乍一看,似乎又回到了那个熟悉的叙事:美国人在用火药造武器,中国人在用火药放烟花。
但这张对比图有一个问题:几组数据不是从同一本账里算出来的。
“中国 55% 的 Token 用于短剧和视频生成”,说的是国内的应用结构;“编程超过 50%”,统计的则是 OpenRouter 等海外平台的全球流量。
前者主要反映中国市场的需求,后者背后却是全世界的用户。
两边的方向差异确实存在。国内 Token 消耗更偏向短剧、电商和营销等消费场景;美国头部模型公司的流量,则更多来自编程、Agent 和企业自动化。
OpenAI、Anthropic 等美国公司服务的是全球市场。中国程序员用 Claude 写代码,中国企业调用 OpenAI 做产品,这些 Token 都会进入美国模型公司的编程和企业数据。反过来,海外开发者调用千问和 DeepSeek,也会增加中国模型的使用量。
所以,美国模型上的 B 端流量,很大一部分来自全球企业;中国公开数据里的 C 端流量,则更多来自庞大的国内消费市场。
连接超级智能 · 探索 AI 工具与大模型实战社区